[2026 KIC Insight4️⃣] AI 기반 임상시험 대상자 매칭: 규칙이 필요한 곳에는 규칙을, 맥락이 필요한 곳에는 생성형 AI를
페이지 정보


본문
셀타스퀘어는 업계의 변화를 가장 먼저 읽고, 고객에게 의미 있는 인사이트를 전달합니다.
지난 10월 15일 열린 2026 KIC(KoNECT International Conference)의 ‘Patient-Focused Drug Development' 세션에서 서울아산병원의 박서윤 연자가 ⌈Finding the Right Patient for the Right Trial: AI-Powered and Patient-Focused Approaches to Clinical Trial Matching⌋을 주제로 발표했습니다. 이번 세션에서는 의료기관이 임상시험 대상자를 찾는 과정에 AI를 어떤 구조로 적용할 수 있는지, 그리고 그 안에서 규칙 기반 도구, 생성형 AI, 연구진의 역할을 어떻게 나누는지 소개했습니다.
데이터, 지식, AI, 사람: 4개 계층으로 설계한 매칭 구조
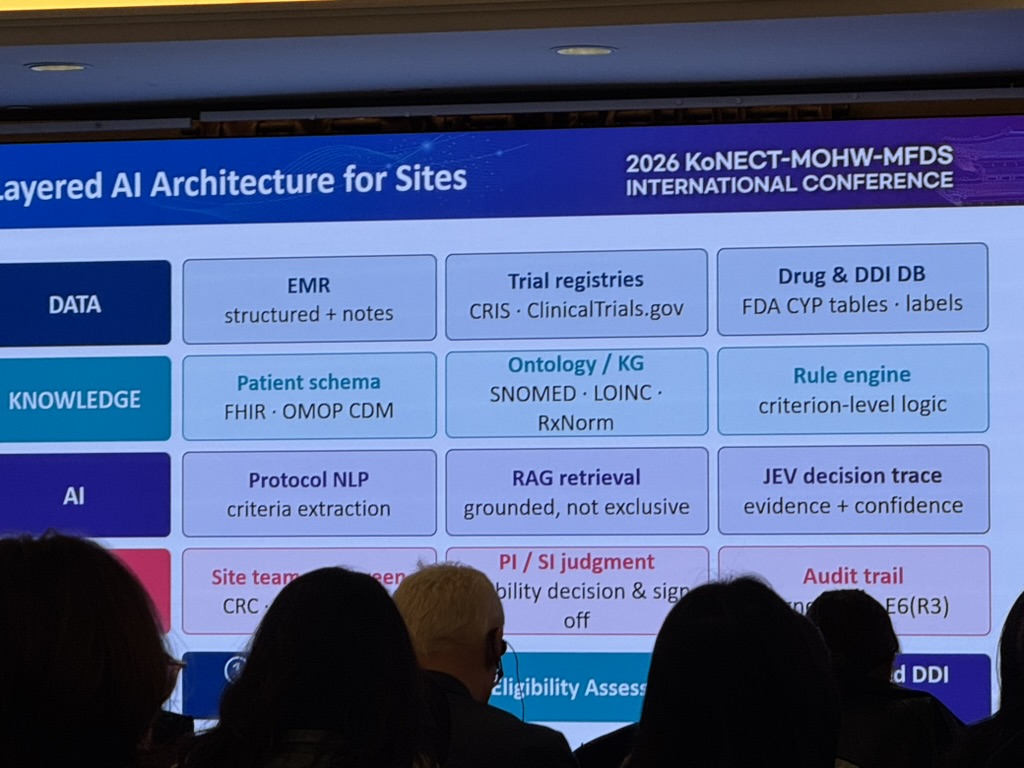
대상자 적격성을 판단하려면 프로토콜의 선정·제외 기준과 환자의 진료기록을 대조해야 합니다. 나이나 검사 수치처럼 기준값이 명확한 조건도 있지만, 이전 치료 이력처럼 진료 노트를 읽어야만 알 수 있는 조건도 섞여 있습니다. 발표에서는 이를 다음 4개 계층으로 나누어 처리하는 구조를 제시했습니다.
ㆍ데이터 계층: EMR, 임상시험 레지스트리, 약물 및 약물상호작용 Database를 결합
ㆍ지식 계층: 환자 정보는 FHIR·OMOP CDM 스키마로, 의학용어는 SNOMED CT·LOINC·RxNorm 기반 온톨로지와 지식그래프로 통일하고 선정·제외 기준은 기준 단위의 규칙 엔진으로 처리
ㆍAI 계층: 프로토콜에서 기준을 추출하는 자연어 처리, 원문 근거에 기반한 RAG 검색, 판단 근거와 신뢰도를 함께 남기는 JEV decision trace
ㆍ사람 계층: CRC가 사전 스크리닝을 준비하고, 권한을 부여받은 연구진이 적격성을 최종 판단하며, 판단 과정은 추적 가능하도록 기록
AI가 후보를 좁히더라도 최종 판단과 책임은 연구진에게 있다는 점이 이 구조의 전제입니다.
하이브리드 방식: Deterministic where it must be, generative where context is needed
발표에서는 명확한
기준은 규칙 기반 도구로 판정하고, 비정형 기록의 해석에는 생성형
AI를 활용하도록 역할을 구분했습니다.
|
구성 요소
|
강점
|
매칭 시 예시
|
|
규칙 엔진 |
결정적 기준값 판정 |
18세 이상, eGFR 45 이상, ECOG 0~1 |
|
온톨로지와 지식그래프 |
용어와 코드 정규화 |
동의어 하나의 개념으로 통합(RxNorm, ATC) |
|
RAG |
원문 근거 연결 |
판단에 쓰인 기준 문구와 프로토콜 개정 버전 |
|
LLM |
비정형 기록 해석 |
진료 노트에 기록된 이전 치료 차수 |
|
JEV decision layer |
구조화된 선택과 신뢰도 |
정규화 → 매핑 → 관계 설정 → 판정(J1~J4) |
|
연구진(CRC, PI, SI) |
판단과 책임 |
CRC가 사전 검토를 준비하고, 권한을 부여받은 연구진이 적격성을 최종 판단 |
국내 약물 데이터는 4단계 온톨로지로 표준화
약물상호작용 판정에서는 국내 약물 데이터를 국제 표준에 연결하는 4단계 온톨로지가 사용됩니다.
1단계(Local codes)에서는 EDI/KD 코드, 주성분코드, 심평원 DUR 정보와 같은 국내 코드를 그대로 가져옵니다. 2단계(Standardize)에서는 OMOP-K 매핑을 거쳐 RxNorm, SNOMED CT substance, WHO ATC/DDD 분류 같은 국제 표준으로 변환합니다. 3단계(Classify mechanism)에서는 RxClass와 MED-RT로 CYP, P-gp 관련 기전을 분류하며, 이 단계에서는 상호작용의 강도가 아니라 기전의 종류만 구분합니다. 4단계(Grade severity)에서는 FDA의 기질, 억제제 및 유도제 분류를 참고해 대사효소 억제 또는 유도 강도를 구분합니다. 예를 들어 민감한 지표 기질의 AUC를 5배 이상 증가시키는 약물은 강한 억제제, 2배 이상 5배 미만 증가시키는 약물은 중등도 억제제로 분류합니다.
SeltaSquare Insight: 약물 데이터 표준화와 판정 단계별 역할 분담
발표에서는 AI 모델보다 데이터 표준화와 역할 분담에 더 큰 비중을 두었습니다. 국내 약물 코드를 국제 표준용어로 연결해야 일관된 판정이 가능합니다. 생성형 AI는 규칙과 온톨로지만으로 처리하기 어려운 비정형 기록의 해석에 제한적으로 사용하고, 최종 판단과 기록은 연구진이 맡도록 설계했습니다. AI 판정의 신뢰성을 높이기 위한 기본 수칙입니다.
셀타스퀘어가 진행 중인 RMP 기반 RWD 안전성 연구도 같은 방향을 따르고 있습니다. 다기관 전자의무기록의 진단, 검사와 처방 정보를 표준용어체계에 매핑하고, 비정형 임상기록에서 자연어처리로 정보를 추출해 이상사례를 탐지하는 설계입니다.
“셀타스퀘어는 표준용어로 정리된 데이터와 AI 분석, 전문가 검토를 유기적으로 연결하는 Evidence Partner입니다.”
